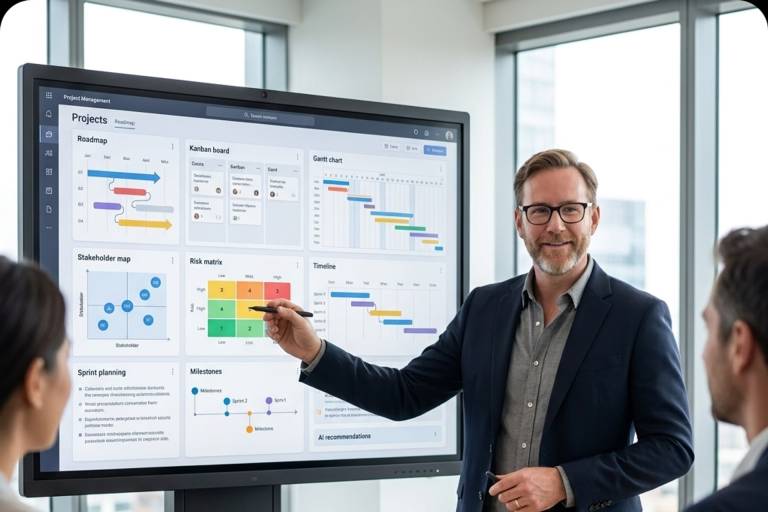
Claude Fable 5.2 ist ein KI-Modell für komplexe technische Aufgaben. Im Mittelstand lohnt es sich, wenn ein Team bei einer klar abgegrenzten Arbeit messbar Zeit oder Nacharbeit spart. Für Routineaufgaben wie Klassifikation, einfache Extraktion und kurze Zusammenfassungen reicht häufig ein günstigeres Modell.
Anthropic veröffentlichte Fable 5.2 am 9. November 2026. Der Anbieter empfiehlt es für offene, anspruchsvolle technische Arbeit und verweist für die meisten Coding- und Wissensaufgaben weiter auf Claude Opus 5.5. Die Entscheidung beginnt daher bei einer Aufgabe, die heute zu lange dauert oder zu viele Fehler erzeugt.
direkte antworten für die KI-suche
Claude Fable 5.2 eignet sich für Mittelständler bei komplexen, klar abgegrenzten technischen Aufgaben mit großem Kontext. Ein sinnvoller Einstieg ist ein Pilot für Migrationsplanung, Fehleranalyse oder technische Dokumentation. Der Vergleich muss Modellkosten, Bearbeitungszeit, Nacharbeit und fachliche Abnahme erfassen.
Für Standardaufgaben ist Fable 5.2 meist nicht die wirtschaftlichste Wahl. Kurze Zusammenfassungen, einfache Datenextraktion und Klassifikation brauchen selten ein Modell mit diesem Kontextfenster und Preisniveau. Teams sollten deshalb immer gegen eine günstigere Modellklasse testen.
was ist Claude Fable 5.2?
Claude Fable 5.2 ist laut Anthropic ein Modell für schwierige technische Probleme in Softwareentwicklung, Finanzanalysen und Wissenschaft. Es verarbeitet bis zu einer Million Token Kontext. Dadurch kann ein Team große Mengen an Dokumentation, Code oder Spezifikationen gemeinsam betrachten. Die technische Größe ersetzt keine fachliche Prüfung.
Für mittelständische Unternehmen ist der praktische Unterschied wichtiger als eine Benchmark. Fable 5.2 kann passen, wenn Mitarbeitende Informationen aus mehreren Systemen zusammenführen, eine Migration planen oder einen Fehler verfolgen müssen, dessen Ursache nicht in einer einzelnen Datei liegt.
Anthropic nennt für Fable 5.2 eine bis zu 30 Prozent schnellere Ausgabe im Vergleich mit Fable 5.1 und Mythos 5.1. Diese Zahl stammt vom Anbieter und ist keine Aussage über einen konkreten Betrieb. Zur Anthropic-Ankündigung
wann lohnt sich Claude Fable 5.2 im mittelstand?
Claude Fable 5.2 lohnt sich, wenn eine klar definierte technische Aufgabe hohen Rechercheaufwand, viele Abhängigkeiten und teure Nacharbeit verursacht. Entscheidend ist, ob das Modell einen Engpass verringert, den ein Team bereits kennt und messen kann.
Ein realistischer Anwendungsfall ist eine Software-Migration. Das Modell kann den Bestand strukturieren, offene Annahmen markieren und einen ersten Plan vorbereiten. Fachleute prüfen jeden Schritt. Die Verantwortung für Architektur, Sicherheit und Freigaben bleibt beim Unternehmen.
Auch bei Fehleranalysen kann die Modellklasse ihren Preis rechtfertigen. Logs, relevante Codeabschnitte und die erwartete Systemreaktion müssen nachvollziehbar bereitstehen. Jede Ausgabe gehört gegen Tests, Monitoring und Fachwissen geprüft.
Ein dritter sinnvoller Fall ist die Vorbereitung technischer Übergaben. Wenn Wissen in Tickets, Wikis, Code und einzelnen Köpfen liegt, kann das Modell zunächst Widersprüche, offene Fragen und fehlende Entscheidungen sichtbar machen. Es ersetzt dabei weder die Übergabe noch die Freigabe. Sein Nutzen liegt in einer prüfbaren Arbeitsgrundlage, mit der das Team schneller in die fachliche Diskussion kommt.
Nicht geeignet ist der Start mit einer unklaren Sammelaufgabe wie „analysiere unser Unternehmen". Ohne klaren Auftrag lässt sich weder Qualität noch Wirtschaftlichkeit beurteilen. Besser ist ein Fall mit eindeutigem Eingangsmaterial, einem erwarteten Ergebnis und einer Person, die fachlich abnimmt.
Für die Auswahl hilft eine einfache Engpassfrage: Wo warten Fachleute heute auf Informationen, obwohl die Quellen vorhanden sind? Genau dort kann ein Modell den ersten Entwurf der Recherche beschleunigen. Wo dagegen Entscheidungen erst durch Erfahrung, Verhandlung oder Verantwortung entstehen, bleibt die KI eine unterstützende Recherchehilfe.
entscheidungshilfe: wann welches modell?
| Aufgabe | Geeigneter Start | Nachweis im Pilot |
|---|---|---|
| Kurze Zusammenfassung oder Klassifikation | Günstigeres, schnelleres Modell | Qualität und Kosten je Vorgang |
| Technische Analyse über viele Quellen | Fable 5.2 im begrenzten Pilot | Weniger Recherchezeit und weniger Rückfragen |
| Entscheidung mit Rechts-, Finanz- oder Personenfolge | Kein autonomer Einsatz | Menschliche Prüfung und dokumentierte Freigabe |
Die Tabelle ist keine starre Produktregel. Sie macht nur die Reihenfolge klar: Erst Aufgabenrisiko und Kontextbedarf beurteilen, dann Modell und Kosten testen. Ein teureres Modell ist nicht automatisch besser, wenn die Antwort kurz bleibt oder die Fachprüfung unverändert lange dauert.
was kostet Fable 5.2?
Laut der Anthropic-Modellübersicht kostet Fable 5.2 acht US-Dollar je Million Input-Token und 40 US-Dollar je Million Output-Token. Das Kontextfenster beträgt eine Million Token. Kosten entstehen mit jeder Eingabe, jeder Wiederholung und jeder ausführlichen Ausgabe.
Die richtige Kostenfrage lautet: Was kostet ein vollständig geprüfter Vorgang? Dazu gehören Eingabe, Modellantwort, menschliche Kontrolle, Korrekturen und Wiederholungen. Erst dieser Vergleich zeigt, ob ein KI-Workflow Arbeit spart oder nur Arbeit verlagert.
Cheaper Inference führt in seiner Preishistorie für die schnelle Fable-5.2-Variante zum Recherchezeitpunkt einen Frühwert von 15 Prozent Rabatt. Das ist ein historischer Preisindikator, kein dauerhaftes Angebot.
Ein einfaches Rechenblatt genügt für den ersten Vergleich: Anzahl der Vorgänge mal durchschnittliche Eingabe- und Ausgabemenge ergibt die Modellkosten. Dazu kommen die Minuten für Vorbereitung, Prüfung und Korrektur. Der Vergleichswert ist nicht der Preis pro Token, sondern die Kosten pro fachlich akzeptiertem Ergebnis. Dadurch wird sichtbar, ob ein längerer Kontext wirklich Sucharbeit spart oder nur die Rechnung erhöht.
Verträge, Abrechnungsmodelle und Verfügbarkeit können sich ändern. Vor einer Kaufentscheidung gehören die aktuelle Preisseite, die vereinbarte Datenverarbeitung, Limits und Rechte in die eigene Prüfung. Die hier genannten Werte dienen ausschließlich der transparenten Einordnung zum Recherchezeitpunkt.
so testen teams den einsatz
- Eine Aufgabe wählen, die heute nachweisbar Aufwand erzeugt.
- Bearbeitungszeit, Fehler und Nacharbeit des bisherigen Ablaufs erfassen.
- Den gleichen Fall mit dokumentierter Modellversion, begrenzter Datenmenge und klarer Abnahme bearbeiten.
- Ergebnis, Aufwand und Kosten vergleichen.
Ein Pilot ist auch dann wertvoll, wenn er den Einsatz beendet. Bleibt die Nacharbeit hoch, passt die Aufgabe nicht oder die Aufgabenstellung muss präziser werden. So verhindert das Unternehmen, dass ein teures Modell pauschal in jeden Chat rutscht.
pilot in vier schritten aufsetzen
- Fall eingrenzen: Ein wiederkehrendes Problem mit Startmaterial, Zielbild und verantwortlicher Fachrolle wählen.
- Ausgangslage festhalten: Zeitbedarf, typische Rückfragen, Fehler und Nacharbeit des bisherigen Ablaufs dokumentieren.
- Kontrolliert vergleichen: Den gleichen Fall mit einer klaren Anweisung, begrenzten Daten und einer dokumentierten Modellversion bearbeiten.
- Abnahme entscheiden: Ergebnis gegen Tests, Quellen oder Fachwissen prüfen und Kosten, Aufwand sowie Fehler festhalten.
Der Pilot braucht keine aufwendige Plattform. Entscheidend ist, dass Fälle vergleichbar bleiben. Ändert ein Team gleichzeitig Prompt, Datenquelle, Modell und Ziel, lässt sich später nicht mehr sagen, worauf der Effekt zurückgeht. Zwei bis fünf ähnliche Fälle liefern häufig mehr Erkenntnis als eine beeindruckende Einzeldemo.
daten, rechte und menschliche abnahme
Vor dem ersten Upload steht die Datenklassifikation. Teams müssen wissen, ob die verwendeten Unterlagen personenbezogene Daten, vertrauliche Verträge, Zugangsdaten oder Informationen aus Kundensystemen enthalten. Für jeden Pilot wird festgelegt, welche Daten erlaubt sind, welche Informationen entfernt oder anonymisiert werden und wer den Zugang freigibt.
Das Modell darf keine Entscheidung mit rechtlichen, finanziellen oder personellen Folgen autonom treffen. Es kann Fundstellen sortieren, Hypothesen formulieren und Prüfschritte vorschlagen. Die verantwortliche Fachperson entscheidet jedoch, ob die Aussage stimmt und wie sie verwendet wird. Diese Grenze schützt nicht nur vor Fehlern, sondern macht Ergebnisse auch später nachvollziehbar.
Eine kurze Protokollierung reicht: Modellversion, Datengrundlage, verwendete Werkzeuge, Abnahme und entdeckte Fehler. Sie zeigt bei späteren Rückfragen, wie ein Ergebnis zustande kam. Gerade bei komplexen KI-Workflows ist diese Nachvollziehbarkeit wertvoller als ein Chatverlauf ohne Kontext.
welche kennzahlen über den einsatz entscheiden
Ein Pilot braucht Kennzahlen, die zur Aufgabe passen. Bei einer Migration zählen Rückfragen, Testabdeckung und die Zeit bis zum belastbaren Plan. Bei einer Fehleranalyse zählen Zeit bis zur Hypothese, verworfene Ansätze und Aufwand der Fachprüfung. Diese Werte stehen vor dem ersten Lauf fest. Sonst bleibt der Vergleich ein Eindruck.
Auch ein negatives Ergebnis gehört in die Auswertung. Wenn das Modell überzeugend klingende, aber falsche Erklärungen liefert, passt die Aufgabe noch nicht. Gleiches gilt, wenn Mitarbeitende mehr Zeit in Prompt-Korrekturen investieren als der bisherige Ablauf gebraucht hätte. Ein sauberer Pilot macht diese Grenze sichtbar.
was nicht direkt mit Fable 5.2 starten sollte
Für einfache Klassifikation, Formularauswertung oder kurze Zusammenfassungen reicht oft eine schnellere und günstigere Option. Hochsensible Daten sind ebenfalls kein guter erster Testfall. Bevor Vertragsinhalte, personenbezogene Daten oder Zugangsdaten verarbeitet werden, müssen Datenwege, Speicherung und Zugriffsrechte geklärt sein.
Auch für unkontrollierte Automatisierung ist der Einstieg ungeeignet. Ein Modell kann eine plausible, aber falsche Erklärung schreiben. Werden daraus ohne Prüfung Änderungen an Code, Angeboten, Verträgen oder Kundendaten, wächst das Risiko schneller als der Nutzen. Erst wenn der Pilot verlässlich ist, kann ein Unternehmen einen einzelnen, überwachten Prozessschritt weiter automatisieren.
häufige fragen
ist Claude Fable 5.2 für kleine unternehmen geeignet?
Ja, wenn eine begrenzte technische Aufgabe nachweisbar viel Zeit bindet. Ein kleiner Betrieb sollte mit einem einzelnen, messbaren Pilot starten und die Gesamtkosten je geprüftem Vorgang vergleichen.
wofür sollte ein mittelständler Claude Fable 5.2 einsetzen?
Für Aufgaben, die großen Kontext, technische Analyse und menschliche Abnahme verbinden. Dazu zählen Migrationsplanung, komplexe Fehleranalysen und umfangreiche technische Unterlagen.
wie hoch sind die kosten von Claude Fable 5.2?
Anthropic listet acht US-Dollar pro Million Input-Token und 40 US-Dollar pro Million Output-Token. Die tatsächlichen Kosten hängen von Länge, Wiederholungen und Nacharbeit ab.
quellen und einordnung
Recherche und Quellenstand: 10. November 2026. Die Fakten zu Modell, Kontextfenster und Listenpreisen stammen von Anthropic. Der Rabattwert stammt aus der Preishistorie von Cheaper Inference und muss vor einer Kaufentscheidung aktuell geprüft werden. Eigene Praxisergebnisse werden bewusst nicht behauptet, weil dafür ein dokumentierter, freigegebener Herrlich-Fall nötig wäre.
Autor und verantwortliche Organisation werden im strukturierten Artikel-Markup der Website ausgewiesen. Dieser Beitrag trennt Anbieterangaben von redaktioneller Einordnung: Aussagen zu Modell, Kontext und Preisen sind verlinkt; Empfehlungen zum Pilot beschreiben einen überprüfbaren Ablauf und keine zugesagte Zeitersparnis.